Posez trois fois la même question à ChatGPT sur votre entreprise : il peut produire des réponses différentes. C’est le premier obstacle quand on veut savoir ce que les modèles disent d’une marque : une réponse d’IA n’est pas un fait à constater, c’est un tirage dans une distribution.
Comment transformer ces réponses mouvantes en mesure exploitable ? C’est le problème que cherche à résoudre PromptForge de Trickstr. PromptForge est un outil développé par Trickstr, intégré à Kosmos, et utilisé pour le Baromètre de l’IA réputation coproduit par Vectors et Trickstr.
Je vous propose de suivre sa chaîne de mesure étape par étape : le cadrage, la collecte, l’évaluation, puis les chiffres du baromètre 2026 et les limites de l’exercice.
Pourquoi une réponse isolée ne suffit pas
Le même modèle, sollicité deux fois avec la même formulation, ne répond pas forcément à l’identique. Une capture d’écran décrit ce qu’un modèle a produit à un instant donné, rien de plus.
Pour en tirer une information exploitable, il faut du volume et un protocole : des questions déclinées en plusieurs formulations, réparties sur toutes les dimensions de la réputation, répétées et intégralement journalisées.
Cette approche se distingue du GEO, qui vise à apparaître dans les réponses : ici, il s’agit de quantifier la perception.
Définir le cadre avant de poser la moindre question
Tout commence par des choix explicites :
- Les modèles interrogés : le baromètre 2026 en retient quatre, Claude, Gemini, ChatGPT et Grok, sollicités pour la plupart via leurs interfaces publiques.
- Les géographies et les langues : une marque n’est pas perçue de la même façon selon le marché interrogé.
- Les variables : l’entreprise, la dimension évaluée, la formulation employée.
- Des formulations neutres : demander « pourquoi cette entreprise est-elle critiquée ? » peut orienter la réponse.
Autre distinction : la présence spontanée et la perception sont deux mesures différentes. Savoir si un modèle cite votre marque de lui-même relève de la visibilité. Savoir ce qu’il en dit lorsqu’on la nomme relève de l’image.
Générer les questions, collecter, tout conserver
Des gabarits de questions sont déclinés par combinaison, entreprise, dimension et formulation, jusqu’à des dizaines de milliers de questions uniques. Elles sont administrées en parallèle aux modèles, avec une journalisation complète des échanges.
Cette journalisation permet de réutiliser un protocole enregistré et de documenter les conditions de chaque collecte. Les modèles, les sources disponibles et les réponses peuvent évoluer : le protocole ne garantit donc ni des conditions ni des résultats identiques.
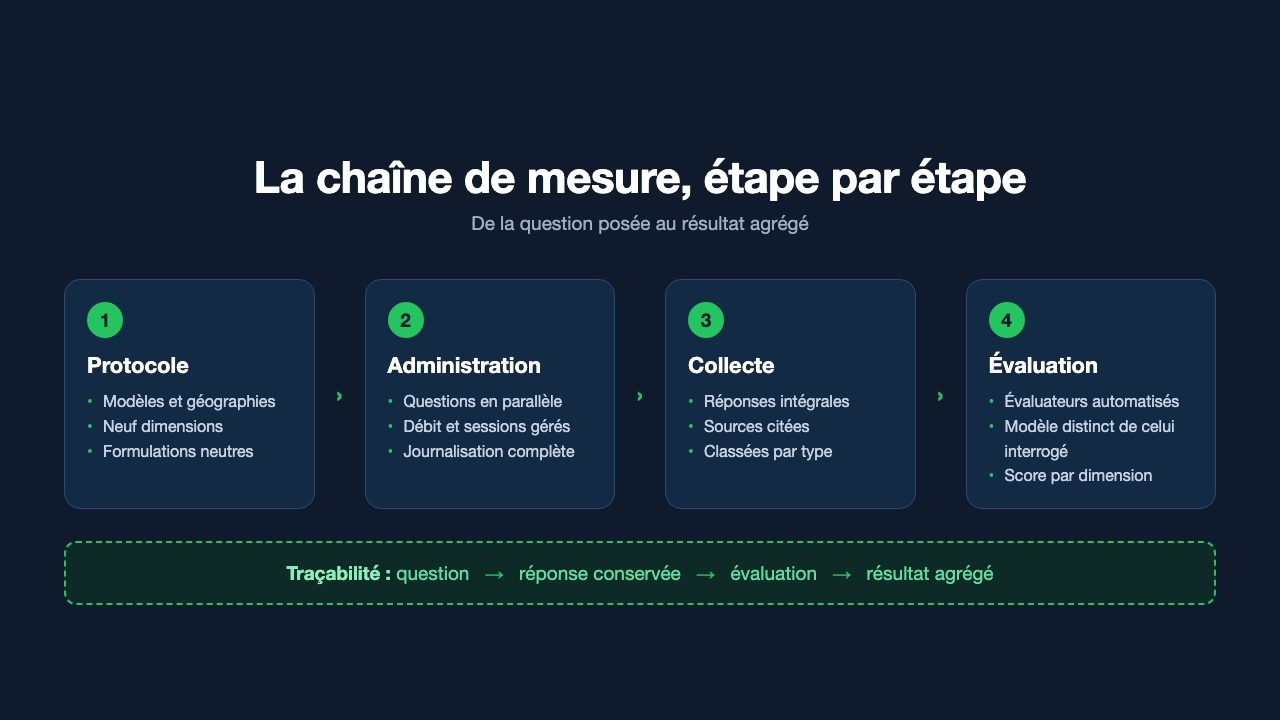
La collecte conserve les réponses intégrales et les sources citées, normalisées et classées par type : sites propriétaires, médias, forums et blogs, encyclopédies, réseaux sociaux.
Évaluer les réponses sans perdre le fil
Chaque réponse est ensuite évaluée sur les neuf dimensions du référentiel : vision et stratégie, produits et services, innovation, marque employeur, performance financière, RSE, capital de marque, gouvernance et adoption de l’IA.
Comment ? Selon la documentation de PromptForge, des évaluateurs automatisés, opérés par un modèle distinct de celui interrogé, analysent les verbatims selon des consignes structurées. L’agrégation statistique produit ensuite les classements et les corrélations entre dimensions.
Le point qui compte le plus à mes yeux : la traçabilité. La chaîne se lit dans les deux sens, question → réponse conservée → évaluation → résultat agrégé. Chaque score peut être redescendu jusqu’aux réponses qui l’ont produit. Cela ne supprime pas les biais d’évaluation, mais cela permet de les examiner.
Ce que donne le baromètre 2026
Le Baromètre de l’IA réputation 2026, coproduit par Vectors et Trickstr et diffusé pour la première fois en juin 2026, applique cette méthode aux entreprises du CAC 40 :
- 39 800 questions administrées
- Quatre modèles d’IA générative interrogés
- Neuf dimensions de réputation évaluées
- Environ 573 000 citations de sources tracées et classées
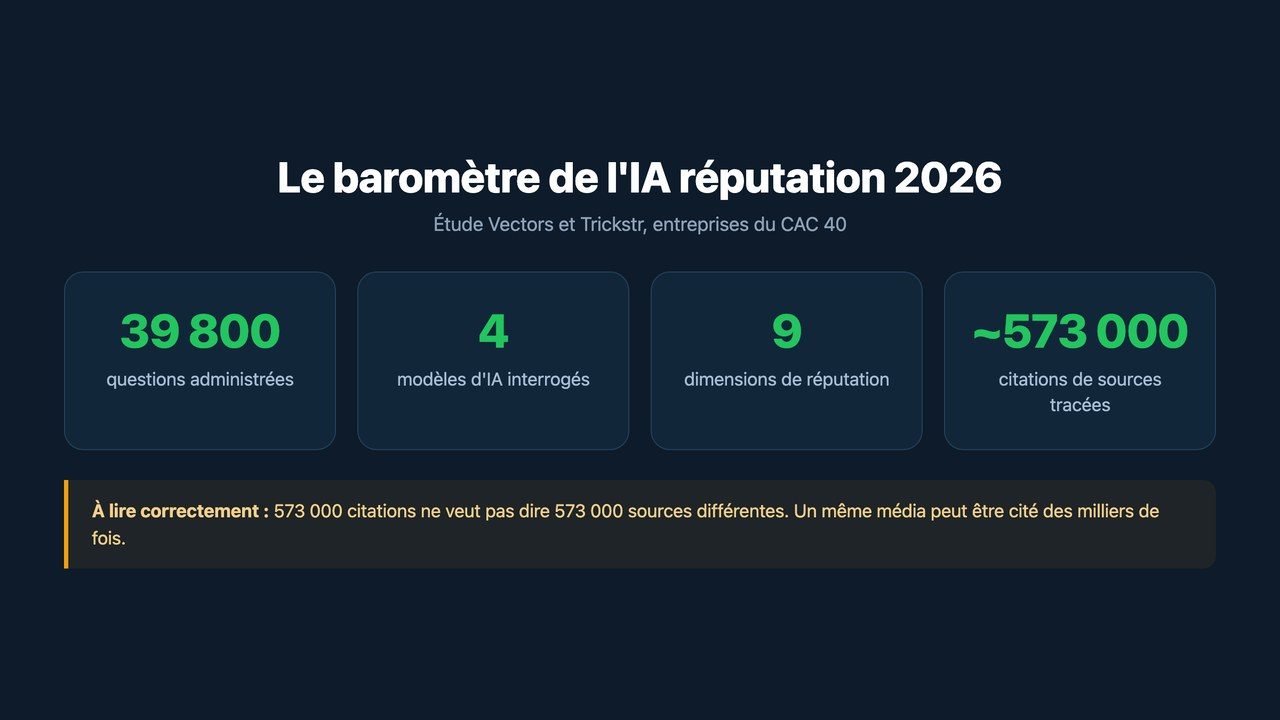
Ce dernier chiffre compte des citations, pas des sources uniques : un même média peut être cité des milliers de fois.
La première édition, en octobre 2025, reposait sur 4 536 questions et sept dimensions. Le corpus élargi permet d’examiner davantage de réponses et de dimensions ; la précision des comparaisons dépend néanmoins du protocole et des biais éventuels.
Trois enseignements ressortent. L’étude relève une forte présence de sources anciennes, concentrées sur 2020-2024, parmi les citations analysées. Ce constat décrit les références mobilisées dans les réponses ; il ne permet pas, à lui seul, de déterminer le rôle des données d’entraînement. Ensuite, notoriété et perception divergent : être connu des modèles ne veut pas dire être bien évalué. Enfin, une poignée de dirigeants concentre l’essentiel des mentions.
Sur ce dernier point, une absence de mention n’équivaut pas à un jugement négatif. Elle doit être interprétée au regard des questions posées, du modèle et des informations mobilisées.
Les limites à garder en tête
Une méthode sérieuse se juge aussi à ce qu’elle ne promet pas :
- La variabilité des réponses : les répétitions permettent de l’observer et de l’estimer, sans la faire disparaître.
- L’évolution des modèles : une nouvelle version peut modifier les réponses mesurées. Un écart entre deux éditions peut venir de l’entreprise comme du modèle.
- La dépendance au protocole : changez les formulations, les modèles ou les dimensions, et vous changez les résultats.
- Les biais d’évaluation : noter une réponse suppose une grille, donc des choix, que l’évaluation soit humaine ou automatisée.
Des répétitions et un protocole documenté peuvent aider à apprécier la variabilité, sans éliminer les biais. Et aucune méthode de ce type ne permet de contrôler ce que les modèles diront de vous, ni de garantir un gain de visibilité.
Ce que ça change pour vous
Trois réflexes suffisent. Regardez la méthode avant le classement : nombre de questions, modèles interrogés, formulations, période. Distinguez ce qui est mesuré, la visibilité dans les réponses des IA ou la perception une fois la marque nommée. Et gardez en tête que ces mesures décrivent un état à un moment donné.
Pour comprendre d’où vient le phénomène, j’avais posé le décor dans mon article sur la façon dont l’IA modifie la réputation des marques.