Une IA qui rédige vos e-mails et résume vos documents sans qu’une seule donnée quitte votre ordinateur, sans abonnement et sans quota : c’est la promesse d’une IA locale. Mais est-ce vraiment exploitable au travail, ou est-ce un jouet pour bricoleurs ?
Pour le savoir, j’ai installé 5 modèles sur un Mac mini M4 avec 16 Go de mémoire et je leur ai donné du vrai travail. Au menu : un e-mail de relance à un client qui n’a pas payé, le guide de la DGFiP sur la facturation électronique (9 000 mots) à résumer, et un petit problème de logique.
Si vous préférez voir les modèles écrire en direct plutôt que me lire, j’ai filmé tout le test, les réussites comme les plantages :
Dans la suite, je reprends chaque modèle avec ses résultats chiffrés, puis je vous montre comment installer une IA locale en quelques minutes. Voici le plan :
Une IA locale, c’est quoi (et pourquoi en vouloir une en entreprise) ?
Une IA locale, c’est le même genre de modèle que celui qui se cache derrière ChatGPT, en beaucoup plus petit. Vous le téléchargez une fois, et il tourne sur votre ordinateur, pas sur un serveur à l’autre bout du monde.
Pourquoi s’embêter, alors que ChatGPT existe ? Pour trois raisons qui pèsent lourd dans une entreprise :
- C’est gratuit et illimité : vous pouvez envoyer 1 000 messages dans la journée, personne ne vous parlera de quota
- Vos données restent chez vous : un contrat, un dossier client ou un fichier de paie ne part sur aucun serveur
- Ça marche sans connexion : dans le train, chez un client, ou sur un poste isolé du réseau
Il y a un piège à éviter dès le départ : open source ne veut pas dire local. DeepSeek V4.1 Flash, sorti en open source le 10 septembre 2026, fait 552 milliards de paramètres. Il est public, mais sur votre ordinateur, il ne tournera jamais. Ollama ne le propose d’ailleurs qu’en version cloud. J’en parle dans mon classement des IA open source, mais ce n’est pas la même liste.
Local, ça veut dire que le modèle rentre dans votre machine. Et ce qui décide de ça, c’est la mémoire vive.
Quelle machine pour faire tourner une IA locale ?
Un modèle, c’est un gros fichier, entre 5 et 8 Go pour ceux de ce comparatif. Pendant qu’il tourne, il doit tenir en entier dans la mémoire vive, plus 2 ou 3 Go pour le système. Voici ce que ça donne sur mon Mac mini pendant que Gemma 4 travaille :
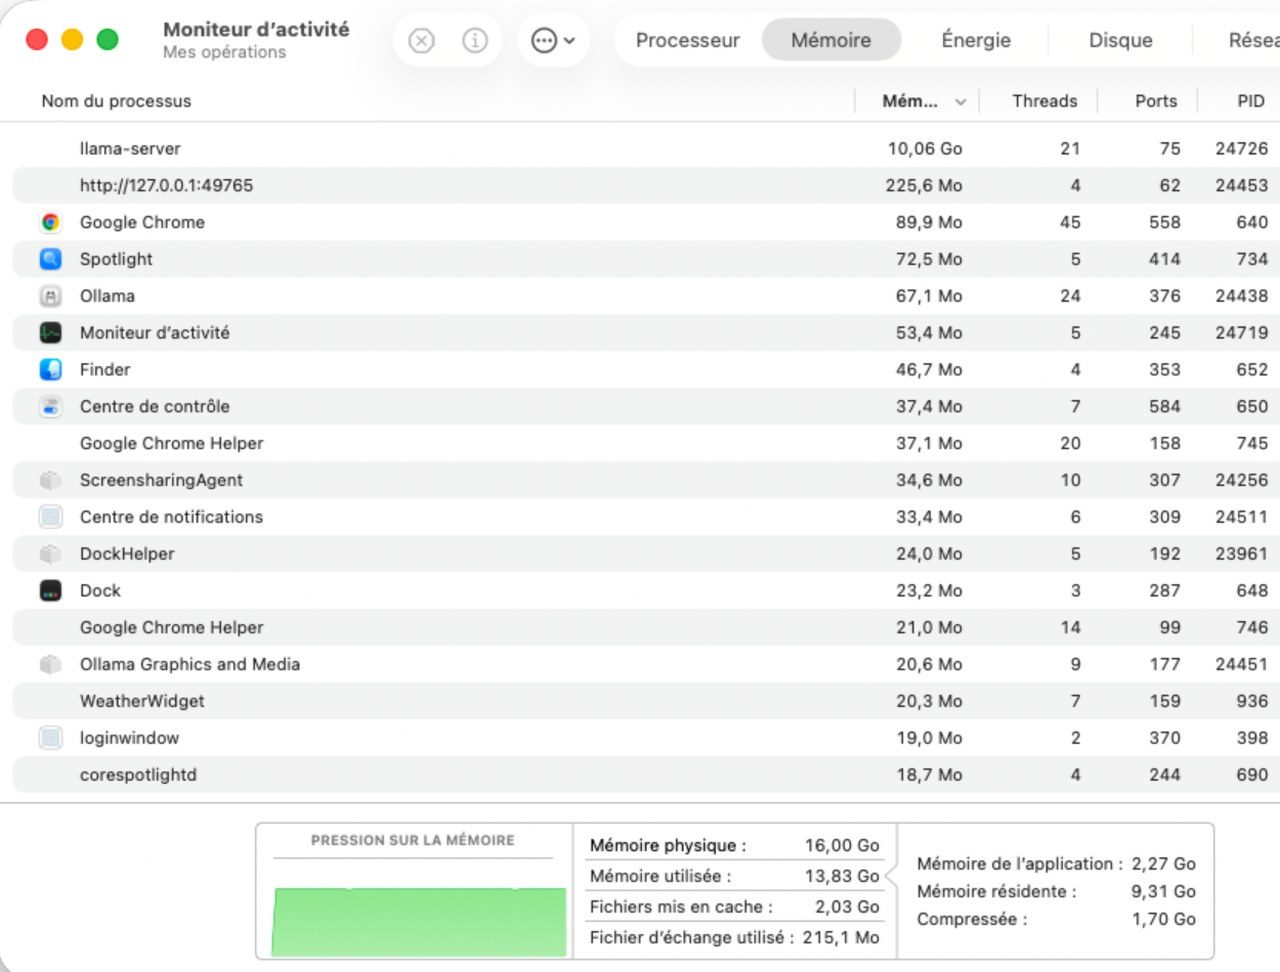
Deux choses comptent quand vous choisissez ou vérifiez votre machine :
- La quantité de mémoire : 16 Go pour les 5 modèles de cette page, 32 Go si vous visez des modèles plus gros, 8 Go avec des versions allégées
- La vitesse de cette mémoire : c’est elle qui décide à quelle vitesse l’IA écrit
C’est pour ça que les Mac à puce Apple, à partir du M1, s’en sortent bien : toute leur mémoire est rapide, et le processeur la partage avec la carte graphique. LM Studio recommande 16 Go et ne supporte plus les Mac Intel.
Sur PC, c’est la carte graphique qui fait la différence. Une Nvidia avec au moins 8 Go de mémoire vidéo et ça tourne bien, les cartes AMD récentes sont aussi prises en charge (la liste est dans la documentation d’Ollama). Sans carte graphique, ça marche, mais c’est lent.
Voyons maintenant ce que valent les modèles eux-mêmes. Pour chacun, j’ai posé les 3 mêmes questions : l’e-mail de relance, le résumé du guide DGFiP en 10 lignes, et le partage d’une addition entre 3 amis.
1. Gemma 4 12B
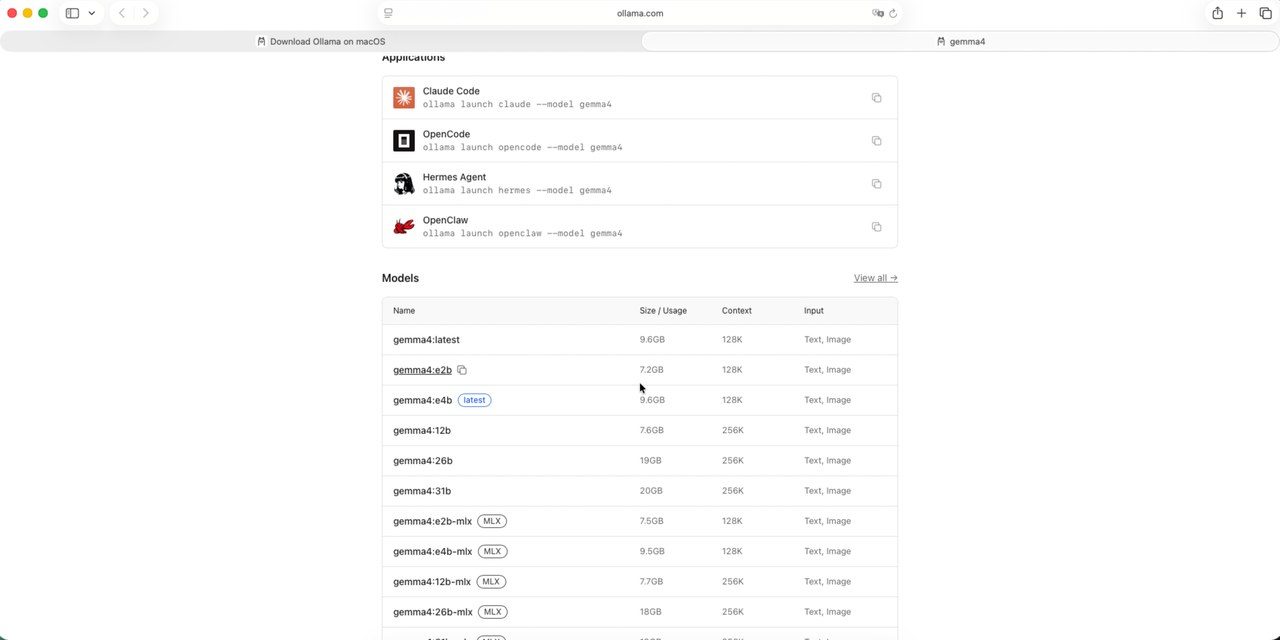
Gemma 4 est le modèle ouvert de Google, sorti en juin 2026. La version 12B compte 12 milliards de paramètres pour un fichier de 7,6 Go. C’est le plus gros des 5, il lit aussi les images, et c’est celui qui a le mieux répondu.
Ce que j’ai observé sur mes 3 tests :
- E-mail de relance : le meilleur des 5, ton juste, français propre, rien à corriger
- Résumé du guide DGFiP : juste, avec toutes les dates, y compris le 1er septembre 2027 pour les PME, en 8 min 30
- Problème de logique : résolu en 1 min 20
Le prix à payer, c’est la lenteur : c’est le plus lent des 5, et le plus gourmand.
- Vitesse : 13 tokens par seconde, soit une dizaine de mots
- Mémoire occupée : 8,4 Go
- Nom dans Ollama : gemma4:12b
- Version allégée : gemma4:e4b, pensée pour les machines à 8 Go
Mon avis : si vous n’en installez qu’un, prenez celui-là. Les 8 minutes sur un document de 9 000 mots se supportent pour une tâche de fond, et la qualité est là. Sur 8 Go de mémoire, passez à la version E4B, la même chose en plus léger.
2. Qwen3.5 9B
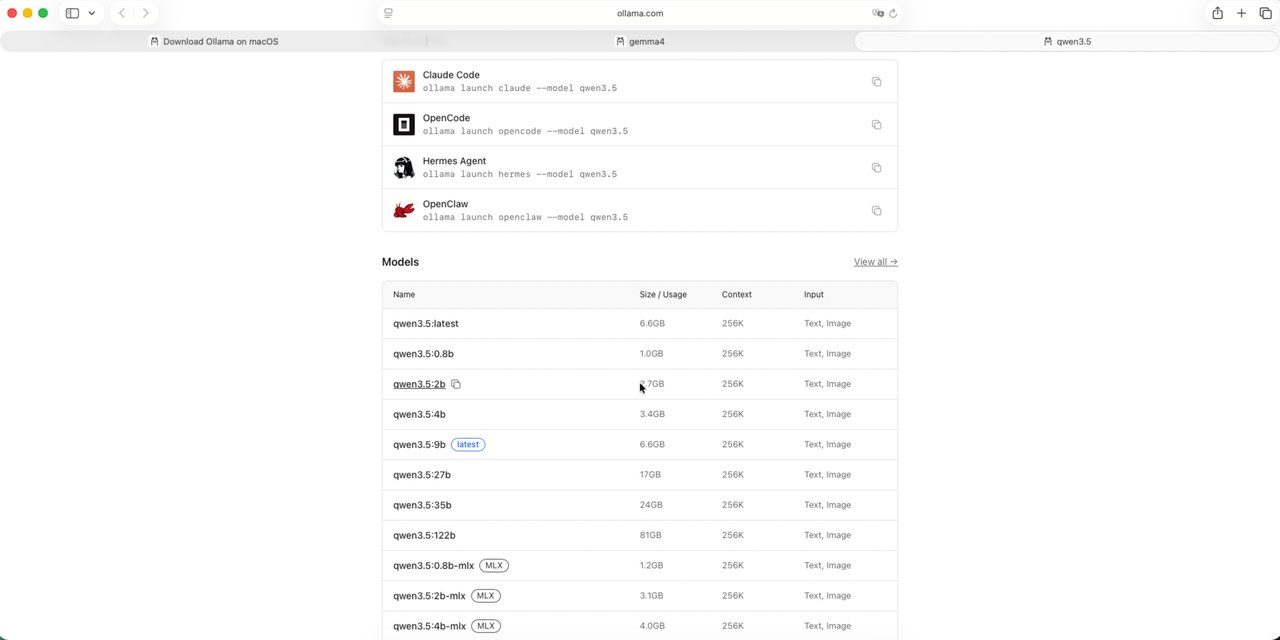
Qwen3.5 est le modèle d’Alibaba. La version 9B pèse 6,6 Go pour 9 milliards de paramètres, avec une fenêtre de contexte de 256 000 tokens. On le présente souvent comme le champion des longs documents, et il a été entraîné sur plus de 100 langues.
Ce que j’ai observé sur mes 3 tests :
- E-mail de relance : une erreur gênante, il signe « L’équipe Martin Conseil » alors que Martin Conseil est le client à relancer
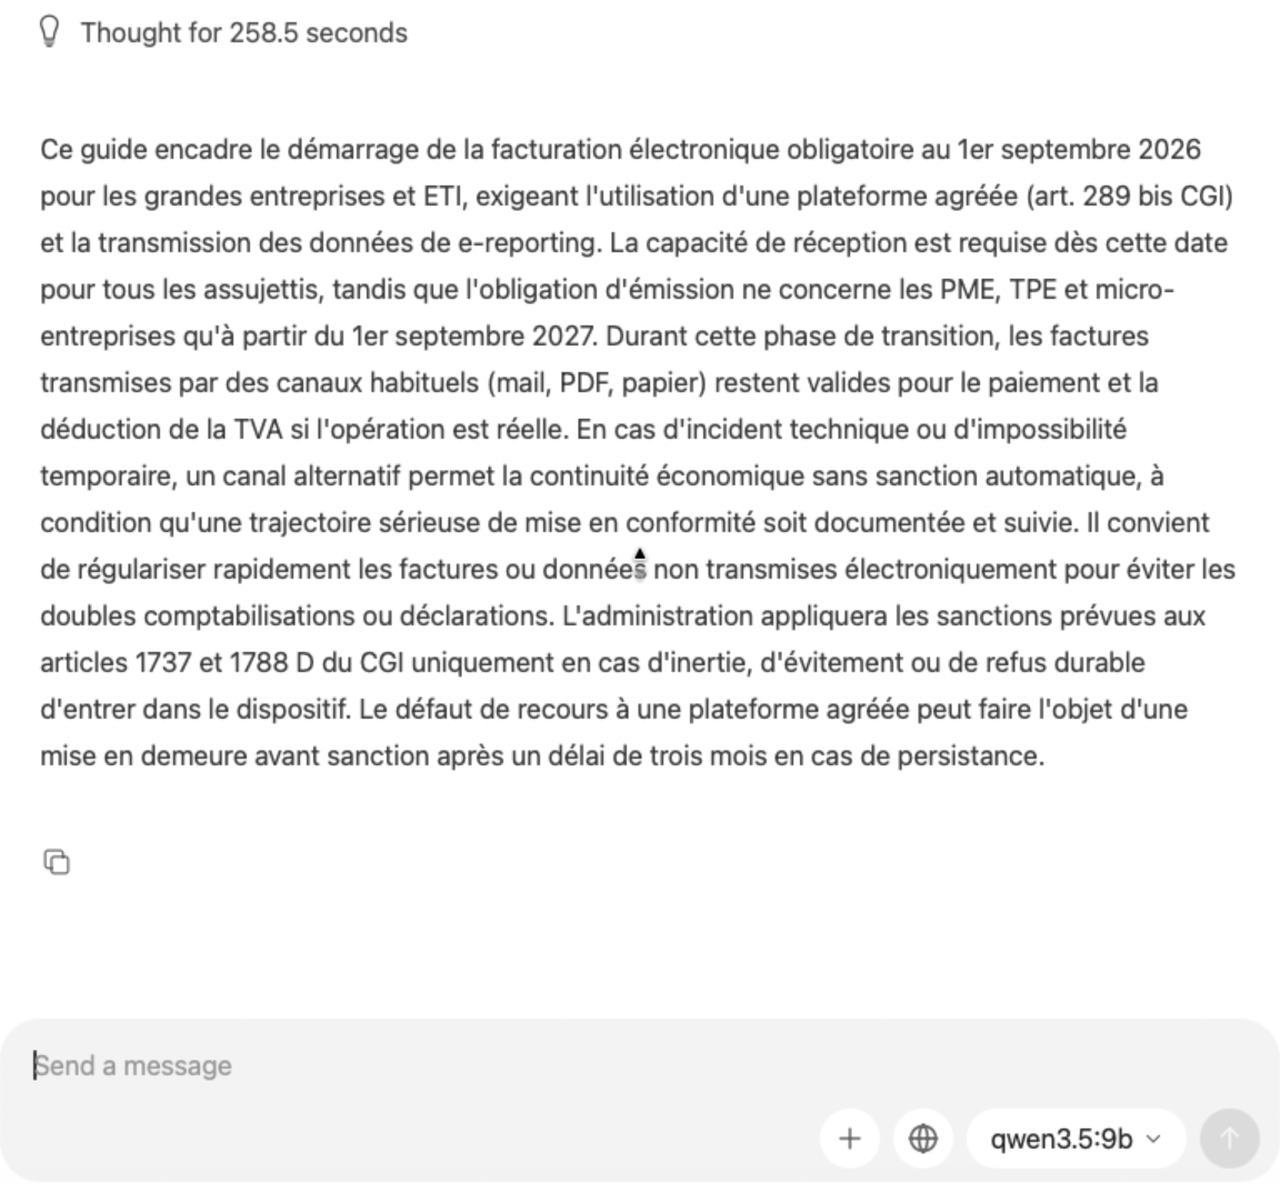
- Résumé du guide DGFiP : les bonnes dates, les bonnes règles, un texte bien construit, en 5 minutes
- Problème de logique : résolu en 1 min 30
Voici son résumé du guide, après plus de 4 minutes de réflexion en anglais avant d’écrire :
- Vitesse : 19 tokens par seconde
- Mémoire occupée : 6,0 Go
- Nom dans Ollama : qwen3.5:9b
- Versions plus petites : 4b (3,4 Go) et 2b pour les machines modestes
Mon avis : le bon compromis si Gemma est trop lent chez vous. Presque la même qualité de résumé, avec 6 Go de mémoire au lieu de 8, et un vrai atout si vous travaillez en plusieurs langues. Relisez la signature de vos e-mails.
3. DeepSeek R1 8B
C’est le nom que tout le monde tape, alors soyons précis. Le DeepSeek que vous pouvez installer chez vous n’est pas le gros DeepSeek du site.
C’est une version réduite de 8 milliards de paramètres et 5,2 Go, sortie en mai 2025 : un modèle Qwen à qui DeepSeek a appris à raisonner, sous licence MIT.
Ce que j’ai observé sur mes 3 tests :
- Problème de logique : la bonne réponse, mais après 4 min 15 et un raisonnement de 2 700 mots pour un calcul de tête
- E-mail de relance : lui aussi se présente comme Martin Conseil, le client
- Résumé du guide DGFiP : le plus faible des 5, il oublie la date de 2027 pour les PME, qui est l’information principale du document
Le raisonnement visible est fascinant à regarder, mais il coûte cher en temps.
- Vitesse : 20 tokens par seconde
- Mémoire occupée : 7,9 Go
- Nom dans Ollama : deepseek-r1:8b
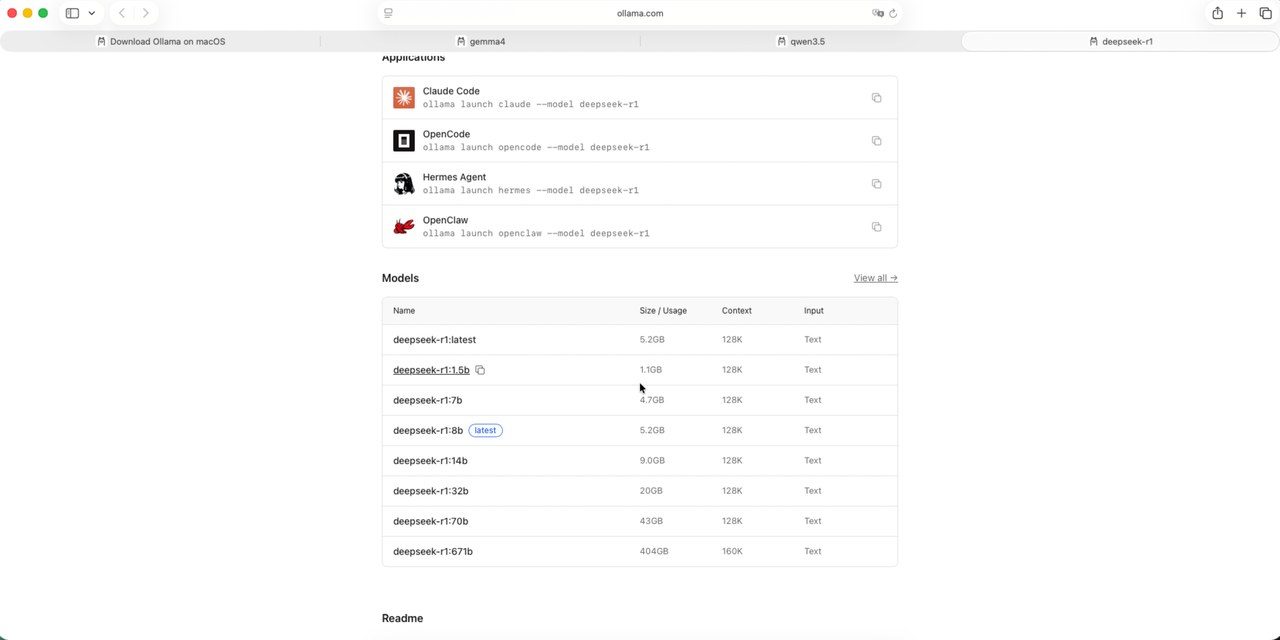
- Autres tailles : de 1,5B (1,1 Go) à 671B (404 Go, hors de portée d’un PC)
Mon avis : intéressant pour comprendre comment un modèle raisonne, et pour coder en local. Pour le travail de tous les jours, Gemma et Qwen font mieux, et plus vite. Si vous voulez quand même l’essayer, j’ai écrit un tutoriel pour installer DeepSeek en privé.
4. Granite 4.2 8B
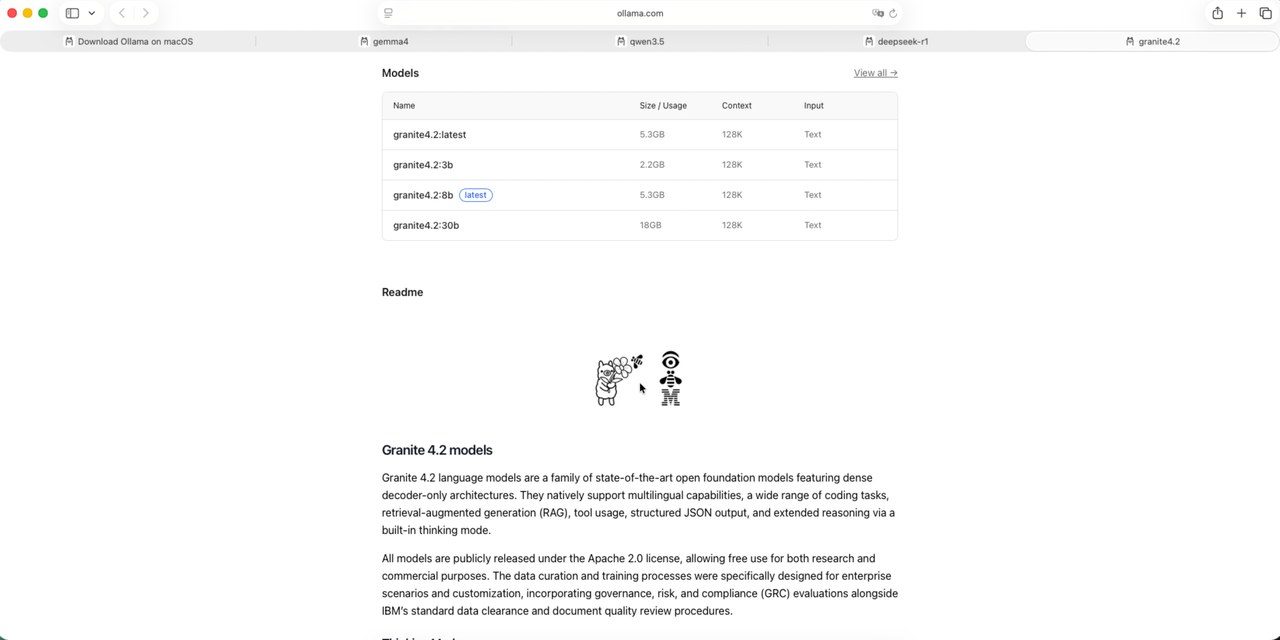
Granite 4.2 est le modèle d’IBM. 8 milliards de paramètres, 5,3 Go, et surtout une licence Apache 2.0 : vous pouvez l’intégrer dans un produit que vous vendez, sans condition. IBM l’a conçu pour l’entreprise, avec le travail sur documents, l’extraction d’informations et les sorties structurées.
Ce que j’ai observé sur mes 3 tests :
- Résumé du guide DGFiP : fidèle, il n’invente rien, mais il rend 550 mots quand je demande 10 lignes
- E-mail de relance : même erreur que les autres, signé « Société Martin Conseil »
- Problème de logique : juste, après 2 160 mots de réflexion et 3 min 20
Un piège au passage : par défaut, il affiche sa réflexion en anglais au milieu de la réponse. Il faut désactiver ce mode pour qu’il réponde proprement en français.
- Vitesse : 19 tokens par seconde
- Mémoire occupée : 8,3 Go
- Nom dans Ollama : granite4.2:8b
- Autres tailles : 3b (2,2 Go) et 30b (18 Go)
Mon avis : le modèle pour les entreprises qui ont besoin d’une licence propre et d’un modèle qui n’invente rien. Pour un usage personnel, les deux premiers sont plus agréables.
5. LFM2.5 8B
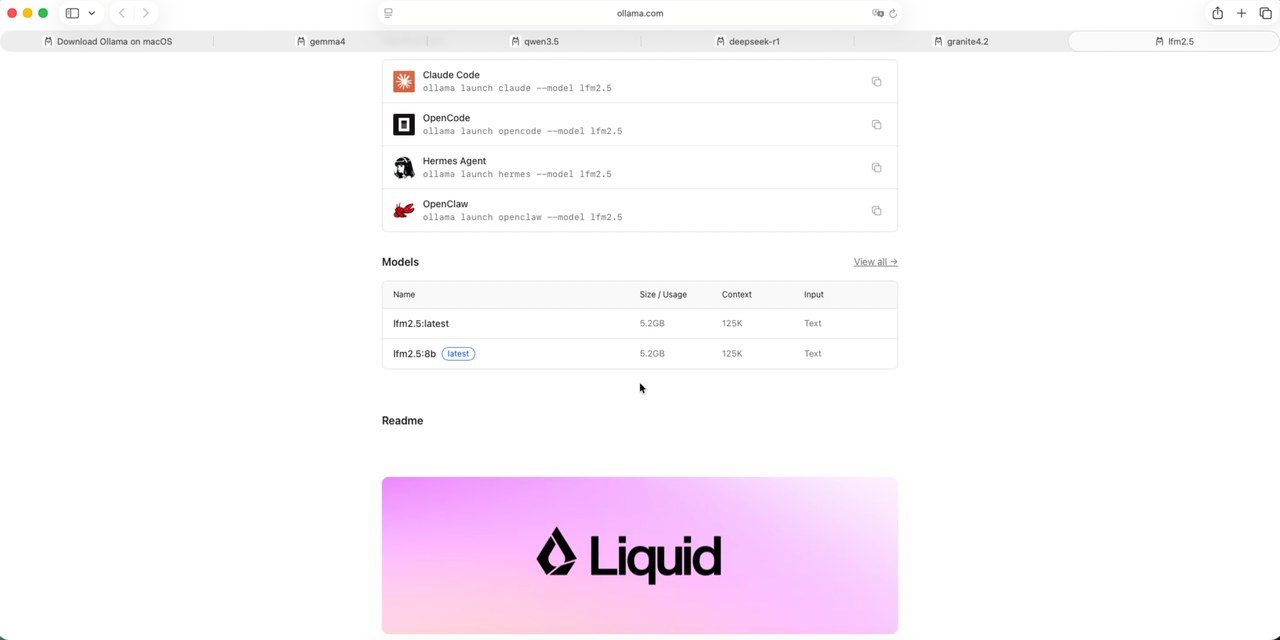
Celui-là, vous ne le connaissez probablement pas. LFM2.5 vient de Liquid AI, une startup issue du MIT, qui l’a construit autrement : 8 milliards de paramètres au total, mais seulement 1 milliard actif à chaque mot. Il ne réveille qu’une petite partie de lui-même, donc il va beaucoup plus vite, pour 5,2 Go.
Ce que j’ai observé sur mes 3 tests :
- E-mail de relance : écrit en quelques secondes, mais lui aussi signe au nom du client
- Résumé du guide DGFiP : complet en 36 secondes, contre 5 à 8 minutes pour les autres, avec une phrase fausse glissée au milieu de choses justes
- Problème de logique : faux, il explique que Julie doit payer 10 euros alors qu’elle doit être remboursée
La vitesse est spectaculaire, mais elle a un prix sur la fiabilité.
- Vitesse : 82 tokens par seconde, 4 à 6 fois plus que les autres
- Mémoire occupée : 5,5 Go, le plus léger des 5
- Nom dans Ollama : lfm2.5:8b
Mon avis : parfait pour tout ce qui est court et facile à vérifier : reformuler, traduire, trier, faire un premier jet. Pas pour un calcul, ni pour un conseil que vous n’allez pas relire.
Tableau comparatif des 5 IA locales
| Modèle | Éditeur | Taille | Mémoire | Vitesse | Point fort | Limite |
|---|---|---|---|---|---|---|
| Gemma 4 12B | 7,6 Go | 8,4 Go | 13 tok/s | Tout bon sur les 3 tests | Le plus lent | |
| Qwen3.5 9B | Alibaba | 6,6 Go | 6,0 Go | 19 tok/s | Résumé juste, 100+ langues | Signature de l’e-mail fausse |
| DeepSeek R1 8B | DeepSeek | 5,2 Go | 7,9 Go | 20 tok/s | Raisonnement visible | Résumé le plus faible |
| Granite 4.2 8B | IBM | 5,3 Go | 8,3 Go | 19 tok/s | Licence Apache 2.0, n’invente rien | Ignore la longueur demandée |
| LFM2.5 8B | Liquid AI | 5,2 Go | 5,5 Go | 82 tok/s | Résumé en 36 secondes | Se trompe sur la logique |
Tests réalisés le 24 septembre 2026 sur un Mac mini M4 16 Go, avec Ollama 0.34.3 et la longueur de contexte réglée à 32k. Je mettrai ce tableau à jour à chaque nouveau modèle testé.
Comment installer une IA locale ?
Pour faire tourner ces modèles, il existe deux applications gratuites : Ollama et LM Studio. Elles font la même chose, télécharger le modèle et vous donner une fenêtre pour discuter avec. La différence, c’est un peu mode automatique contre mode manuel. Voici l’essentiel, et j’ai détaillé chaque écran, système par système, dans mon guide pour installer une IA en local.
Méthode 1 : Ollama, la plus simple

Avec Ollama, vous tapez le nom du modèle, il prend la bonne version pour votre machine, et vous parlez. C’est ce que j’ai utilisé dans la vidéo, parce que mes 5 modèles y sont, en un clic. Si c’est votre première IA locale, prenez celui-là.
- Télécharger l’application : version Mac (macOS 14 minimum) ou Windows, puis l’ouvrir
- Refuser le compte : au premier lancement, cliquez sur « No thanks, I’ll use Ollama locally »
- Choisir le modèle : dans le sélecteur en bas de la fenêtre, tapez gemma4:12b ou l’un des noms cités plus haut
- Attendre le téléchargement : quelques minutes selon votre connexion, une seule fois
- Écrire votre message : comme dans ChatGPT
Le réglage à changer en premier : la longueur de contexte
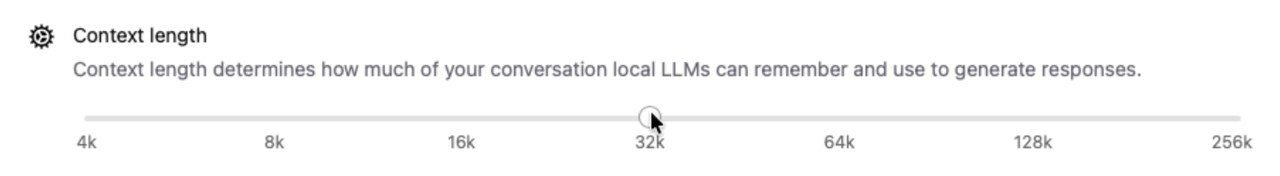
Voici le réglage que personne ne vous dit, et que j’ai découvert en faisant mes tests. Dans les réglages d’Ollama, la ligne Context length fixe la quantité de texte que le modèle peut garder en tête. Par défaut, elle est trop courte pour un vrai document.
Quand j’ai donné mon guide de 9 000 mots aux modèles avec le réglage d’origine, 2 d’entre eux ont renvoyé une réponse vide, et 2 autres n’en ont lu que la moitié, sans me le dire. Montez ce curseur à 32k, et là ça marche.
Méthode 2 : LM Studio, pour garder la main
LM Studio va chercher directement dans Hugging Face, la grande bibliothèque des modèles. Vous avez beaucoup plus de choix, mais 10 versions pour chaque modèle, et c’est à vous de choisir la bonne. En échange, il vous montre tout.
- Onglet Discover : cherchez le modèle et prenez la variante 4 bits, la plus légère
- Mémoire et vitesse affichées : vous voyez ce que le modèle consomme en temps réel
- Format MLX sur Mac : souvent un peu plus rapide qu’Ollama sur les puces Apple
Les autres méthodes
Ollama et LM Studio couvrent 90 % des besoins, mais d’autres logiciels ont chacun leur cas d’usage :
- Jan : l’alternative open source à ChatGPT, tout en local par défaut, avec un code entièrement auditable
- Msty : un client tout-en-un sans terminal, avec ses « Knowledge Stacks » pour interroger vos PDF et vos dossiers
- GPT4All : le projet historique de Nomic AI, conçu pour les machines modestes sans carte graphique, 100 % hors ligne
- AnythingLLM : un « ChatGPT d’entreprise » privé, avec espaces de travail et gestion des utilisateurs, pour qu’une équipe interroge ses documents internes
- Open WebUI : l’interface web qui transforme Ollama en portail IA interne, accessible depuis un navigateur
- LocalAI : un serveur qui expose une API compatible OpenAI, pour brancher vos applications existantes sur un modèle local
- Llamafile : le modèle et le moteur dans un seul fichier exécutable, sans installation, idéal pour une démo
- Pinokio : un « app store » d’applications IA locales qui installe et configure les projets open source en quelques clics
Alors, une IA locale, c’est exploitable en entreprise ?
Ma réponse, c’est oui, mais pas pour tout, et il faut savoir où sont les limites.
Les 4 limites que j’ai rencontrées :
- La qualité : un modèle de 8 milliards de paramètres n’est pas GPT-5 ni Claude, qui en ont des centaines de milliards. Sur l’e-mail, 4 modèles sur 5 ont confondu l’expéditeur et le client, avec le même aplomb que quand ils ont raison
- L’isolement : pas d’internet, donc pas d’actualité ni de recherche, pas de mémoire d’une conversation à l’autre, et aucune connexion à vos outils
- La machine : les 5 modèles occupent 30 Go sur le disque, vous n’en chargez qu’un à la fois, et sur un long document la seule lecture prend 1 à 2 minutes avant la première ligne
- Les mises à jour : rien ne se fait tout seul, quand un nouveau modèle sort, c’est vous qui allez le chercher
Donc voilà mon verdict. Pour écrire, résumer, reformuler, trier, avec le bon modèle, c’est exploitable aujourd’hui, sur une machine à 16 Go, et c’est gratuit. Pour tout ce qui doit être fiable sans relecture, un calcul, un conseil, une information précise, ce n’est pas encore là.
Ce rôle, c’est le cloud qui le garde, et mon classement des meilleurs modèles d’IA vous dit lesquels. L’idée, c’est de mettre en local ce qui est confidentiel, répétitif ou hors ligne, et de garder ChatGPT ou Claude pour le reste.
Comment choisir son IA locale ?
Vous avez 16 Go de mémoire ou plus ?
Installez Gemma 4 12B, c’est le seul qui a tout bon sur mes 3 tests. Acceptez qu’il soit lent sur les longs documents, et lancez-le pendant que vous faites autre chose. Avec 32 Go, vous pouvez viser Gemma 4 26B ou Qwen3.5 27B, qui pèsent 17 à 19 Go.
Vous n’avez que 8 Go ?
Prenez Gemma 4 E4B, la version allégée, ou Qwen3.5 4B à 3,4 Go. Vous perdez en finesse, mais vous gardez un assistant utile pour reformuler et résumer des textes courts.
Vous travaillez en plusieurs langues ?
Qwen3.5 est entraîné sur plus de 100 langues, c’est le choix évident. Et si la souveraineté compte pour vous, regardez aussi les modèles de Mistral dans mon comparatif des meilleures IA françaises.
Vous voulez intégrer le modèle dans un produit ?
Granite 4.2 et sa licence Apache 2.0 vous évitent toute mauvaise surprise juridique. Pour générer du code en local, DeepSeek R1 et Qwen3.5 tiennent la route, et j’ai détaillé les options dans mon guide des meilleurs modèles IA pour coder.
Vous avez besoin de vitesse avant tout ?
LFM2.5 écrit 4 à 6 fois plus vite que les autres. Réservez-le aux tâches courtes que vous relisez : traduction, reformulation, tri, premier jet.
Conclusion
Une IA locale gratuite, illimitée et qui garde vos données chez vous, c’est réel en 2026, sur un ordinateur normal à 16 Go. Ce n’est pas encore le niveau du cloud, et 4 modèles sur 5 me l’ont rappelé sur un simple e-mail.
Concrètement : installez Ollama, montez la longueur de contexte à 32k, téléchargez Gemma 4 12B, et confiez-lui ce que vous ne voulez pas envoyer à ChatGPT. Le reste, vous le verrez à l’usage, et cette page suivra les nouveaux modèles au fil de mes tests.